


2026年9月,京东(JD)科技集团高管的一句公开表态,点出了这个市场的结构:
京东(JD)同时是数据的采购方、采集方和场景方。(界面新闻,2026-09-01)
同一时期,智元自2025年底启动「一分为四」战略,将灵巧手、数据、租赁、四足机器人四项业务拆分独立,数据板块独立为觅蜂科技。京东(JD)则提出依托供应链优势建成「全球规模最大、场景最全」的具身智能数据采集中心,两年内积累超1000万小时数据,并推出自研采集终端、具身大模型与数据交易平台。
头部企业正在把自身用量最大的那部分数据供给,握在自己手里。这一趋势已经很清楚。
但它没有回答的是:哪些部分仍然值得外采。
为什么是引擎,而不是仓库
静态数据集会老化。模型能力在变,本体在变,哪些任务是短板也跟着变。
引擎知道自己有什么、缺什么、下一步该采什么、哪些素材值得做昂贵的加工、哪些已经冗余。
它是一个闭环,不是一个对象存储。
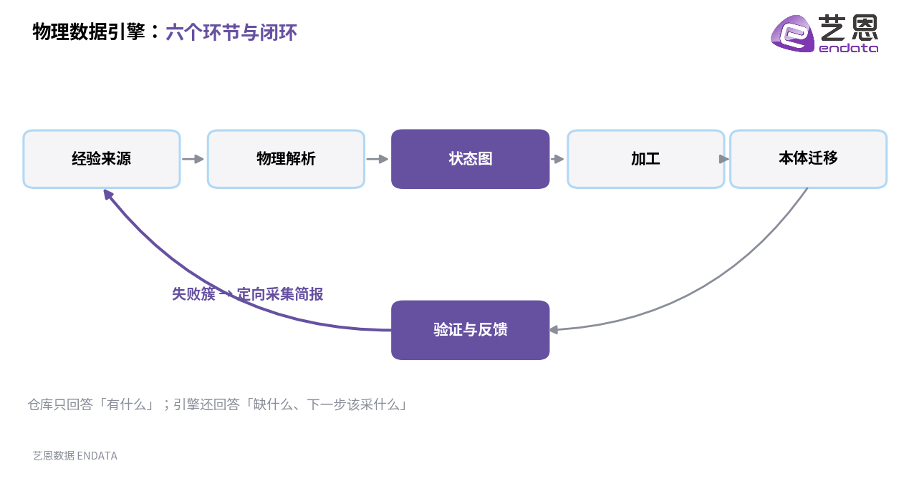
图|经验来源→物理解析→状态图→加工→本体迁移→验证与反馈,最后回到采集。
这一点上,国内的产业共识已经相当清晰。上海交通大学杨理欣的表述是:行业缺的不只是更多高质量数据,而是一个能够将现场错误持续转化为训练素材的「回环」——机器人在现场出错后由人接管,纠正过程被记录并送回训练,再把更新后的模型重新部署(澎湃科技,2026-09-02)。
工信部《2026年度人形机器人(886069)与具身智能实景实训专项行动通知》也提出,聚焦工业、服务、特种三大领域重点场景,加速构建「实景实训—数据沉淀—产品迭代—规模部署」闭环。
产业侧已有公开的闭环实践,也已经有了可量化的结果。在上海创智学院与智元机器人联合发布的成果中,通过实时回流机器人在真实环境中的任务执行数据更新模型,长程任务的平均子步骤得分较传统监督微调(SFT)方法提升近50%(经界面新闻2026-09-20报道)。
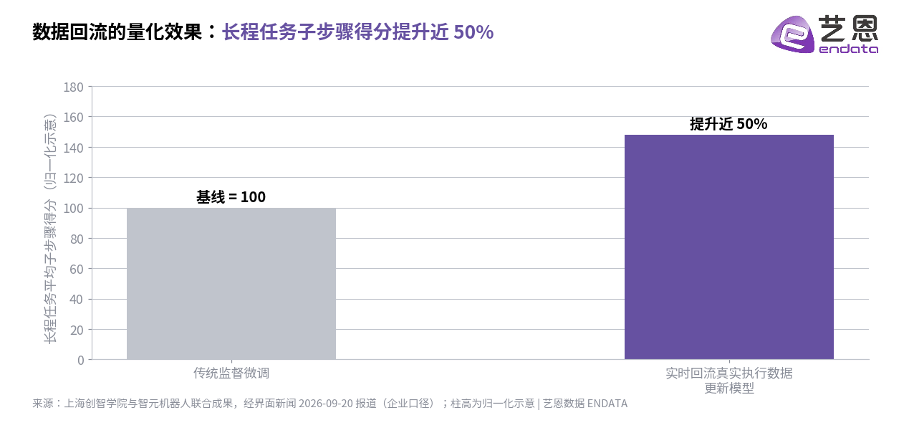
图|上海创智学院与智元机器人的联合成果:以真实执行数据回流更新模型,长程任务平均子步骤得分较SFT提升近50%(企业口径)。
另有供应商披露其回流数据飞轮每轮可推动任务成功率提升5%至10%(企业自述,未经独立验证)。这类数字应当被当作闭环存在的证据,而不是闭环效果的定量结论。
世界模型(World Model)的转向在这里还有一个运营层面的后果:随着学出来的世界模型越来越多地充当强化学习与后训练的环境,数据层就不再只喂策略,而是开始喂策略所处的环境。语料里的一个缺口,会变成仿真世界里的一个缺口。
「三位一体」引出的第二个问题
当一家企业同时是采购方、采集方和场景方,它的数据服务能卖给谁?
一个本体厂商的数据子公司,天然会被它母公司的竞争对手排除在供应商名单之外;一个拥有全国零售场景的平台,它的采集网络对同业而言既是资源也是风险。
这不是国内特有的现象,海外市场已经演过一遍:2025年6月,Meta(META)以143亿美元取得Scale AI 49%股权并延揽其创始人。随后路透社援引知情人士称,Scale AI最大客户Google计划终止合作,微软(MSFT)与xAI也在重新评估;OpenAI确认逐步结束与Scale AI的合作,但表示此前半年到一年已在收缩。
中立性不是一种姿态,它是一种可交易的资产——而且它的价格会随着行业集中度上升而上升。
垂直整合吃不掉的三类供给
- 在被扩张的那套采集配置下物理上不可观测的信息——例如遮挡背后的几何真值和真实的力;
- 需要重新组织物理场景才能获得的数据——例如严格配对的人-机器人采集;
- 并非自己一手采集的素材所需的权利链。
在规模上与垂直整合的买方正面竞争的数据生意,很难有胜算;能提供规模本身换不来的东西的数据生意,才有自己的位置。
集中化会来,但它压缩的是哪一层
行业内的判断是会走向「寡头分布」,理由是数据采集重投入、强调系统化工(850102)程与运营能力、也很看重资金能力;同时在数据标准尚未统一的阶段,客户正在从「每家都采一点、试一试」转向集中选择一两家供应商(澎湃科技、华尔街见闻,2026-09)。
这个判断大概率对,但需要补一句:寡头化压缩的是「通用小时数」这一层,不是全部。
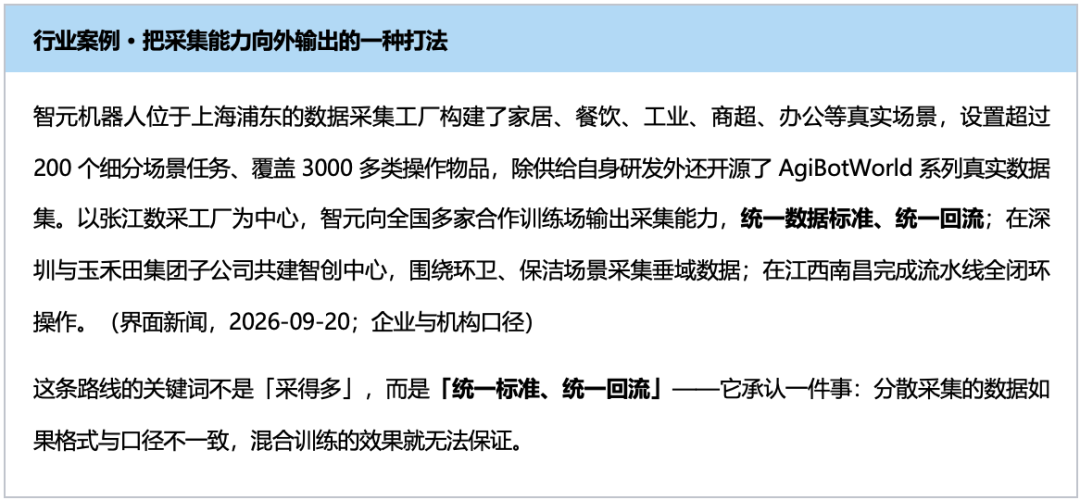
同一篇报道里也提到,一家模型公司同时用几家供应商的第一视角(Egocentric)数据,混合训练效果很难保证——这恰恰说明集中化的驱动力是接口不统一,而不是能力不可替代。一旦相关行业标准落地(数据集质量要求将于11月1日实施),接口统一带来的集中压力会下降,而按能力分工的空间会重新打开。
艺 恩 判 断
物理数据引擎有三个阶段,叠加而非替换,顺序不能跳。近期是能被理解的产品:第一视角采集、重建、动捕、定制采集——这一层拼执行与良率。中期是对齐语料、面向本体的转换、带基准测试的数据包——这一层拼对齐能力和它背后的证据基础。长期是常设基础设施:输入一个能力目标或一个失败簇,输出下一步最值得训练的物理经验。近期的良率立不住,对齐类产品没人愿意听;中期的证据拿不出来,基础设施的说法就只能停留在PPT上。
三个问题,现在就能自查
01·模型失败时,你的数据系统会自动做出调整吗?如果从失败簇到采集简报靠的是一次会议,而不是一条管线,闭环就没有闭上。
02·有哪些数据是你自己采不了的?每个认真的项目都该把这份清单写下来。遮挡真值、实测力和严格配对采集,出现在大多数清单上。
03·你的数据预算是一条实验支出,还是一条基础设施支出?答案决定了合同形态、规划周期(883436),以及有没有人对这份语料作为一项资产负责。


