


随着人工智能(885728)(AI)模型从训练向高级推理及智能体(Agentic AI)演进,基础设施的重心正从“算力主导”悄然转向“内存主导”。
面对日益高企的“内存墙(Memory Wall)”,知名投行Bernstein在最新发布的深度研报中指出,高带宽闪存(HBF,High Bandwidth(BAND) Flash)有望成为破局的关键。该技术不仅有望大幅降低AI推理成本,更可能为深陷周期(883436)泥潭的NAND行业带来类似HBM对DRAM行业的重塑效应。
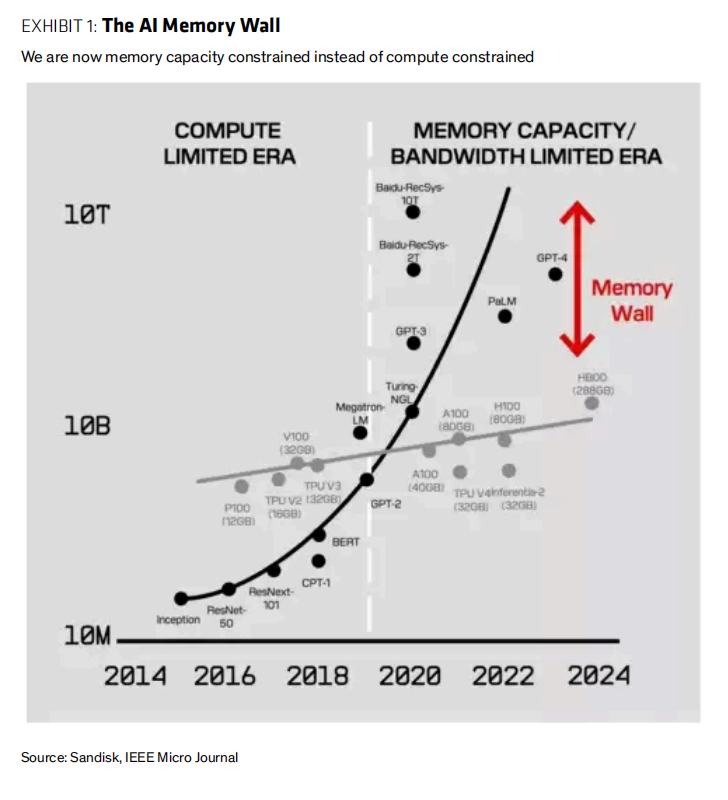
AI演进催生“内存墙”,推理与智能体成算力消耗大户
Bernstein在报告中指出,AI技术的迭代正在重塑底层硬件需求。在训练阶段,GPU和HBM(高带宽内存)占据了核心地位;但随着大语言模型参数规模呈指数级扩张、上下文窗口不断拉长(逼近或超过100万Token),以及智能体对持久交互的迫切需求,海量数据(603138)已远超HBM的经济容量边界,正逐步向传统DRAM、NAND闪存乃至HDD和磁带等更广泛的存储层级溢出。
分析师Mark C.Newman及其团队在报告中强调,推理过程尤其是解码阶段,属于典型的“内存带宽受限”场景。
在混合专家模型(MoE)架构下,尽管单次推理仅激活部分专家,但庞大的总参数集仍需随时待命。此外,缓存机制(KV Cache)创造了巨大的经济激励——目前主流AI实验室和谷歌对缓存Token的读取定价仅为全新输入Token的约10%。
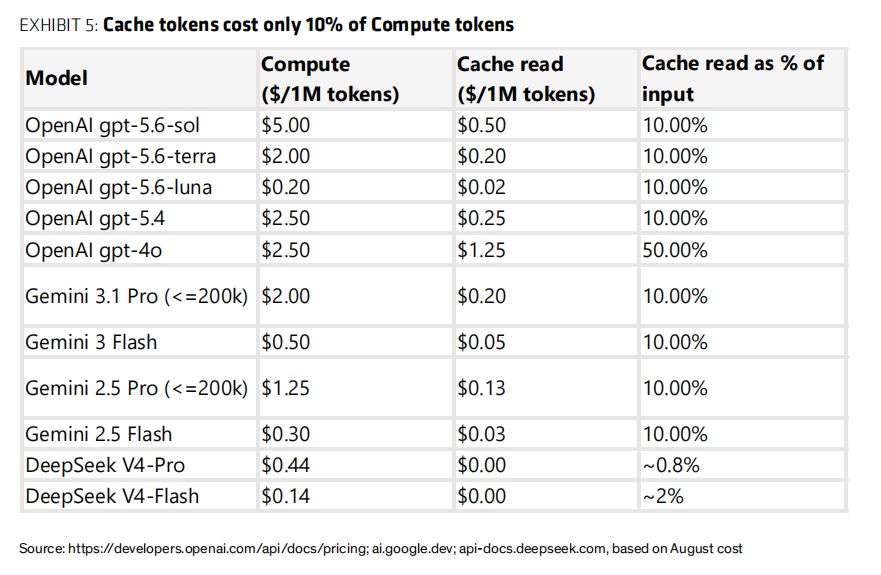
这意味着,为了避免昂贵的重复计算,系统需要更大容量、更高带宽的内存来存储和复用既往上下文。单纯增加算力已难以提升系统利用率,内存容量和带宽正成为制约AI发展的核心瓶颈。
HBF架构横空出世:兼顾HBM级带宽与8-16倍容量
为跨越这道“内存墙”,HBF技术应运而生。它通过高度并行、宽接口的架构,将NAND闪存堆叠,旨在提供接近HBM的读取带宽,同时实现8至16倍的容量跨越,且每GB成本大幅低于HBM。
在闪迪(SNDK)(SNDK.US)提出的HBM+HBF分层架构中,容量较小但延迟极低的HBM继续作为处理最活跃工作集的“高速缓存”,而HBF则作为“容量层”,用于存储海量模型参数(如MoE架构中的非活跃专家)以及温/冷KV缓存数据。SK海力士(SKHY)(SKHY.US)此前提出的H3架构也印证了这一思路。
这种架构的经济效益极为显著。闪迪(SNDK)的模拟测试(基于Qwen3-480B-A35B模型)显示,在纯HBF配置下,仅需1颗GPU即可运行960GB的bfloat16模型,而纯HBM方案最少需要8颗GPU。即便是需要输出同等Token的场景,4颗HBF GPU即可媲美8颗HBM GPU的性能。
通过大幅减少对昂贵GPU和HBM的依赖,HBF不仅降低了单位GB的内存成本,更从系统级层面优化了资本支出(CapEx)和功耗,实现了“避免重复计算”的架构级飞跃。
晶圆消耗比高达6.5倍,毛利率却比肩HBM
从经济学角度剖析,HBF对NAND产业链的利润增厚效应极具想象力。由于其采用高性能、高耐久度的SLC(单层单元)闪存,并需额外增加硅面积以容纳TSV(硅通孔)和外围电路,Bernstein测算HBF的晶圆消耗比(Trade Ratio)高达6.5倍,远高于HBM的3倍;其制造成本比约为企业级SSD(eSSD)的10倍。
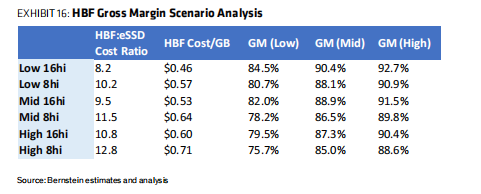
然而,得益于其极高的溢价能力,若HBF以类似HBM的模块单价(但提供8-16倍容量)进行定价,其毛利率有望达到惊人的80%-90%,基本与当前NAND行业的顶尖盈利水平持平,且大幅增厚营收与利润。
报告基准测算显示,在2027年HBM ASP(平均售价)预期下,8-hi和16-hi HBF模块的毛利率中枢将分别达到86.5%和88.9%。
重塑NAND供需格局:类似HBM之于DRAM的“杰文斯悖论”
HBF的普及有望为NAND行业带来类似HBM对DRAM行业的结构性利好。一方面,高达6.5倍的晶圆消耗比意味着,即便HBF仅占10%-20%的迁移率,也将导致行业晶圆需求激增20%-120%。在当前晶圆厂扩产缓慢、资本开支巨大的背景下,这将极大收紧NAND的供需平衡,支撑价格与利润率。
另一方面,HBF创造了全新的AI驱动需求,打破了传统企业级SSD的存量博弈。
市场普遍担忧HBF会侵蚀HBM的需求,但Bernstein认为,二者更多是互补关系。HBF虽减少了存储模型参数所需的HBM容量,但无法替代用于活跃计算和Token生成的HBM。
更低的AI推理成本将加速AI应用的普及,根据“杰文斯悖论”,整体效率的提升反而可能刺激更大规模的AI部署,从而带动HBM、GPU以及NAND的总需求呈指数级增长。
生态博弈与落地挑战:英伟达的缺席与闪迪的野心
尽管前景广阔,HBF的全面商业化仍面临架构限制与生态挑战。由于底层仍是NAND,HBF的读取延迟在微秒级,无法达到DRAM的纳秒级;其写入性能和耐久度也存在天花板。因此,HBF更适用于读多写少的推理场景。
更核心的挑战在于生态支持。目前,HBF联盟已吸纳闪迪(SNDK)、SK海力士(SKHY)、谷歌(GOOGL.US)、Meta(META)(Meta(META).US)和Tensorrent等巨头,但行业风向标英伟达(NVDA)尚未明确背书。相反,英伟达(NVDA)(NVDA.US)正积极推广其CMX(内容内存存储)平台以及Storage Next方案。此外,台积电(TSM)(TSM.US)也尚未披露针对HBF的先进封装(886009)(CoWoS)产能规划。
作为HBF的核心推手,闪迪(SNDK)正凭借其在NAND IP、前端制造(与铠侠合资)及系统级封装上的垂直整合优势,全力推进HBF落地。据披露,闪迪(SNDK)首代HBF产品已成功流片,并计划于2027年推出首批面向推理的样品,第二代产品则将瞄准边缘计算领域的1000亿参数级模型。
综合来看,HBF为打破AI内存墙提供了一条极具性价比的演进路径。虽然前路仍受制于延迟短板和英伟达(NVDA)等大厂的生态抉择,但其一旦规模化落地,无疑将为NAND产业注入强劲的结构性增长动能,开启存储行业的“HBF时代”。


