


近日,中国证券报记者走进无锡(惠山)国产智算中心,模块化的液冷GPU机柜有序排列,嗡嗡作响的空调(884113)声之外,是2000张摩尔线程(688795)MTT S5000几乎满载运行。这个国产GPU集群从今年6月点亮到实现满载,只用了两个多月。
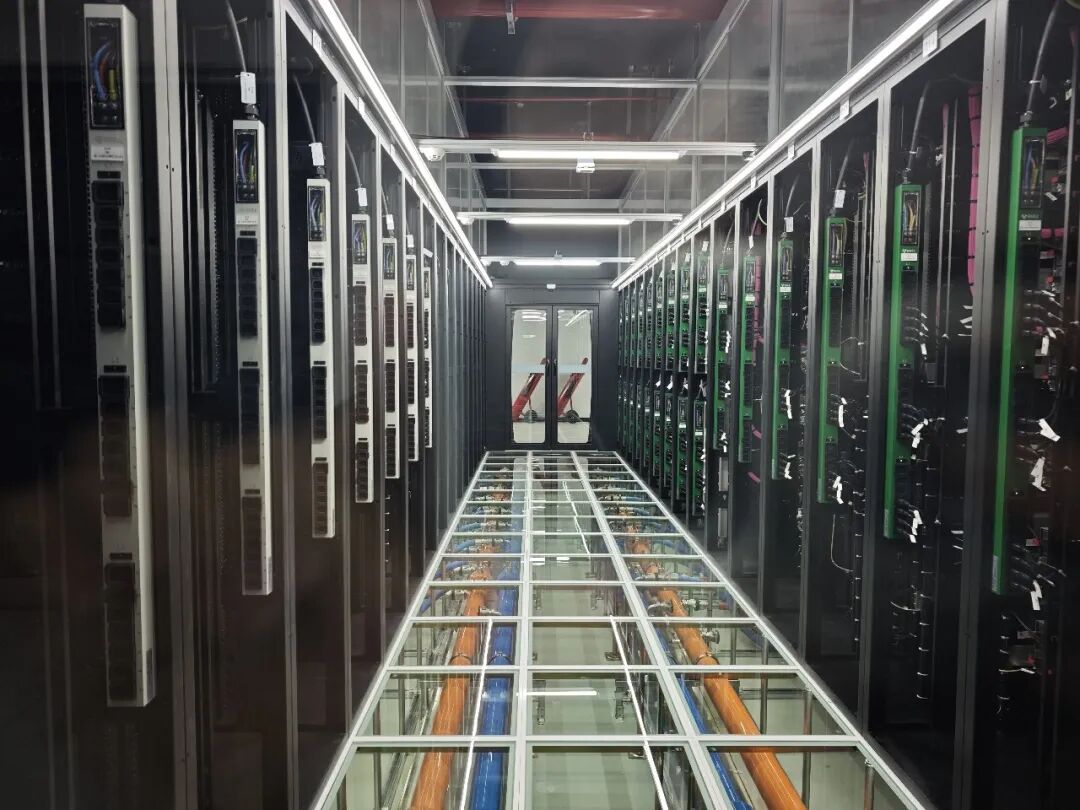
无锡(惠山)国产智算中心本报记者杨洁/摄
作为项目的运营方,无锡市惠山招商集团副总经理张涛告诉记者:“截至目前,92%以上的集群算力已在使用中,付费用户占比超过60%。整体上,算力是供不应求的趋势,有许多客户正在等待我们的集群算力腾出来以后,进一步做测试。”
国产算力的“供不应求”同样体现在财报中。近日,国产GPU龙头摩尔线程(688795)发布2026年三季报显示,第三季度营业收入为15.52亿元,同比增长1773.9%,环比增长55.4%,创单季新高,扣非净利润也早于计划首次实现转正。
92%以上的算力都在被使用
2000卡在算力集群里并不算很大,但意义非凡。“规模不能太小,太小的话有一些业务跑不起来,2000卡可以适配大多数厂商的需求。”张涛解释当初投建国产智算中心的考虑,要先让用户在国产算力集群上完成适配,把业务跑通,再根据实际需求一步步考虑向万卡扩容。“截至目前,92%以上的集群算力已在使用中,付费用户占比超过60%。整体上,算力是供不应求的趋势,有许多客户正在等待我们的集群算力腾出来以后,进一步做测试。”
新石器慧通科技股份有限公司(简称“新石器”)正在依托无锡(惠山)国产智算中心开展自动驾驶模型训练验证,效果优异。随着自动驾驶技术研发的深入,新石器计划在智算中心开展更大规模的自动驾驶模型训练,加速物理AI落地,算力需求接近万卡级规模。
记者了解到,在这一算力平台上,已经有20余家客户在开展测试或正式业务,覆盖模型训练和推理等,其中训练业务占比超过62%。摩尔线程(688795)副总裁、生态合作总经理方朝霞介绍,这些训练主要以后训练为主。
作为用户,朗境创新副总裁周凌谈到,自主算力集群是能不能自主定义物理AI规则边界的“核反应堆”,其中特别难的是AI计算、高保真渲染、物理仿真三类负载在同一架构下强同步、低抖动、时序零漂移。“物理先验模型里,物理状态和视觉观测只要错一帧,学出来的就是错误因果。摩尔线程(688795)全功能GPU把‘算、渲、仿’放在单芯片MUSA统一架构里完成,减少跨栈数据搬运和时钟偏差。这也是为什么我们考察了多个算力集群之后,觉得摩尔全功能GPU以及无锡惠山的算力集群是最符合我们要求的。”朗境创新是北京大学图形智能实验室科技成果转化的公司,正在推进物理AI和高端航空工业仿真模拟的产业化落地。
摩尔线程(688795)副总裁、生态合作总经理方朝霞的体会更加直观:“过去,国产算力卡几乎没有人愿意来试,到后面大家慢慢来试,试完之后都觉得是个惊喜,到现在试完之后都愿意付费,是一个非常大的跨越。”
按需向万卡级集群演进
无锡(惠山)国产智算中心还有一个身份:“东数西算”长三角枢纽苏南算力集聚区惠山节点。这意味着,它将承担长三角如上海、苏州的外溢算力需求。方朝霞介绍,目前无锡本地用户约占50%到60%,整个长三角合计占到70%到80%。
在工业经济发达的东部打造大规模算力集群,用电和能效是需要重点考虑的问题。方朝霞介绍,模块化的机柜采用的是液冷散热方式,能让GPU跑出更好的性能,整个集群PUE稳定在1.2以下,未来还计划研究浸没式液冷,让散热更彻底。
此外,据无锡惠山区政府网站,惠山节点提出要“探索与连云港(601008)核电(885571)、青海海东绿电的虚拟直供机制,把PUE稳定控制在1.25以下”。
方朝霞透露,一期2000卡部署之初,已经在按照未来万卡级规模进行规划考量,“万卡级集群工程上的问题我们已经解决了,真正的挑战是在10万卡,这是一个涉及到计算、存储、散热、数据交换各方面协同的系统性工程。”她介绍,2027年建设10万卡集群是摩尔线程(688795)一个非常重要的战略,并且将按客户需求采取更集约的“超节点”架构。今年9月,京东(JD)云和摩尔线程(688795)宣布达成深度合作,拟建设10万卡全功能GPU集群,打造自主可控的超大规模算力底座,满足物理AI低延迟、高可靠的训练与落地需求。
张涛表示:“现在我们建智算中心的逻辑是‘分步走’,后续的扩容会按照整体客户的需求节奏妥善推进,不会大张旗鼓先建后用。”


